Semaphore et Ansible : le guide technique pour installer, sécuriser et automatiser vos playbooks
Semaphore : l'interface web open source qui pilote vos playbooks Ansible sans ligne de commande, de l'installation Docker à l'automatisation...

Le SRE (Site Reliability Engineering) est une discipline qui applique les principes de l’ingénierie logicielle aux problèmes d’exploitation, dans le but de rendre les systèmes fiables et scalables.
Le DevOps, lui, est une culture et un ensemble de pratiques visant à rapprocher développement et exploitation.
Les deux ne s’opposent pas : le SRE est une façon concrète et outillée de mettre en oeuvre la philosophie DevOps, avec un vocabulaire précis de la fiabilité, les SLI, les SLO et les error budgets.
Ce guide explique l’origine et les principes du SRE, la différence réelle avec le DevOps, les concepts clés (SLI, SLO, SLA, error budget, toil), le rôle de l’ingénieur SRE, et comment démarrer une démarche sans se tromper de cible.
Le SRE est né chez Google autour de 2003, bien avant l’apparition du terme DevOps. L’idée fondatrice est simple à énoncer et exigeante à appliquer : confier l’exploitation à des ingénieurs logiciels, et leur demander de traiter les problèmes d’opérations comme des problèmes de logiciel.
Plutôt que d’absorber manuellement la charge d’exploitation, on l’automatise, on la mesure et on l’industrialise.
Sa finalité est la fiabilité au sens de l’utilisateur, pas la disponibilité théorique d’un serveur. Le SRE part du principe qu’un système parfaitement stable mais figé n’a pas de valeur, et qu’un système qui change en permanence sans garde-fou finit par casser.
Toute la discipline consiste à arbitrer explicitement entre vitesse de changement et fiabilité, à l’aide d’indicateurs partagés plutôt que d’opinions.
| Critère | DevOps | SRE |
|---|---|---|
| Nature | Culture et ensemble de pratiques | Discipline d’ingénierie avec un cadre prescriptif |
| Périmètre | Large, à l’échelle de l’organisation et du flux de valeur | Ciblé sur le service et l’expérience de l’utilisateur final |
| Question centrale | Comment livrer plus vite et mieux ensemble ? | Comment garantir la fiabilité tout en continuant à livrer ? |
| Outil de décision | Métriques DORA, boucles de retour | SLI, SLO et error budget |
| Traitement de l’exploitation | Responsabilité partagée entre les équipes | Automatisation et plafonnement du travail répétitif (toil) |
La formule la plus juste est celle de Google : le SRE croit aux mêmes choses que le DevOps, mais pour des raisons légèrement différentes.
Le DevOps prescrit des objectifs (casser les silos, automatiser, mesurer) sans dire précisément comment les atteindre ; le SRE apporte un cadre opérationnel, des indicateurs chiffrés et des règles de décision.
On résume souvent cette complémentarité par une analogie : si le DevOps est une interface, le SRE en est une implémentation possible.
Une nuance importante pour les organisations : le DevOps s’intéresse à l’ensemble de l’entreprise, y compris aux silos et aux flux d’information, là où le SRE se concentre sur la façon d’exploiter correctement un service.
Le SRE soutient l’intégration et la livraison continues, mais d’abord parce qu’elles améliorent les pratiques opérationnelles, pas seulement pour la vitesse de livraison.
Pour bâtir une fiabilité durable sans paralyser l’innovation, le Site Reliability Engineering s’appuie sur six principes fondamentaux. Ces pratiques de SRE transforment la façon dont les équipes gèrent les services en production, en privilégiant la mesure sur l’intuition et l’automatisation sur le travail manuel :
Ces trois termes sont souvent confondus alors qu’ils désignent trois niveaux distincts, qui forment une hiérarchie.
| Terme | Définition | Exemple |
|---|---|---|
| SLI (Service Level Indicator) | La mesure brute de la qualité de service perçue | Part des requêtes HTTP réussies sur une fenêtre glissante de 28 jours |
| SLO (Service Level Objective) | La cible interne fixée pour un SLI sur une période donnée | 99,9 % de requêtes réussies sur 30 jours |
| SLA (Service Level Agreement) | La promesse contractuelle faite au client, avec conséquences | 99,5 % de disponibilité, avec pénalités en cas de manquement |
La logique est cumulative : sans SLI fiable, impossible de fixer un SLO crédible ; sans SLO tenu, impossible d’honorer un SLA.
Une règle de prudence s’impose : le SLO interne doit toujours être plus strict que le SLA externe. Si l’engagement contractuel porte sur 99,5 %, viser un SLO de 99,9 % laisse une marge de réaction avant de violer le contrat.
L’error budget est la quantité d’indisponibilité autorisée par le SLO, c’est-à-dire l’écart entre 100 % et la cible retenue.
Pour un SLO de 99,9 % sur un mois, le budget d’erreur représente 0,1 % du temps, soit environ 43 minutes. Ce budget n’est pas une tolérance passive : c’est une ressource que l’équipe dépense volontairement en déploiements, en changements d’infrastructure et en expérimentations.
Son intérêt est de remplacer un débat d’opinion par une règle partagée. Tant que le budget n’est pas consommé, les équipes livrent normalement. Lorsqu’il est épuisé, la priorité bascule automatiquement vers la fiabilité, en gelant les évolutions le temps de rétablir la situation. Développement et exploitation cessent ainsi de s’opposer, puisqu’ils partagent le même indicateur.
Un budget jamais consommé n’est d’ailleurs pas un bon signe : il révèle en général un SLO trop conservateur ou une prise de risque insuffisante.
Le toil désigne, selon la définition d’origine, le travail lié à l’exploitation d’un service en production qui est manuel, répétitif, automatisable, tactique, dépourvu de valeur durable, et qui croît linéairement avec la taille du service.
Les exemples abondent :
Le SRE traite le toil comme un problème d’ingénierie et non comme une fatalité.
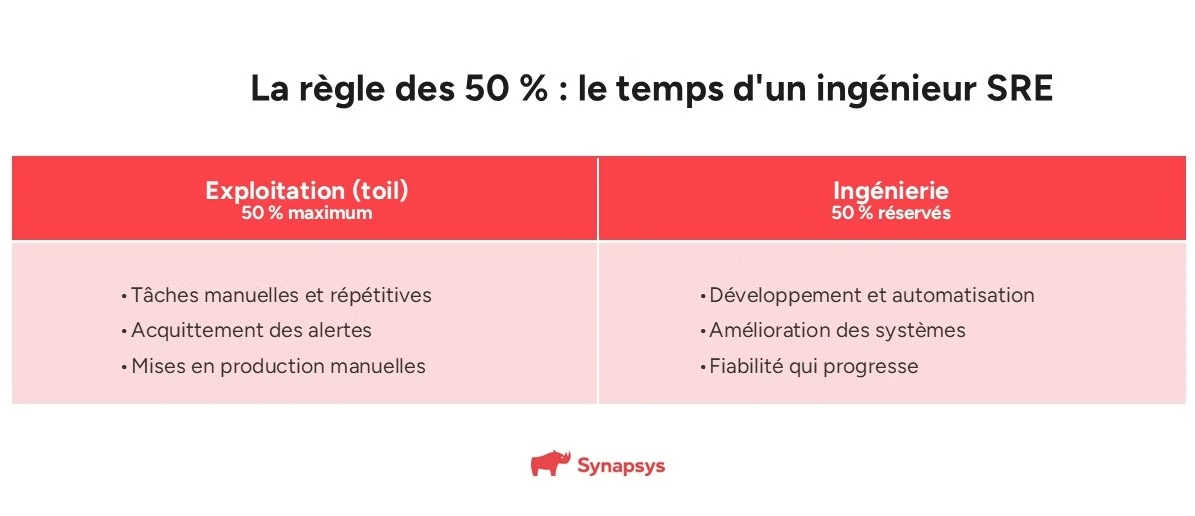
La règle la plus connue est le plafond de 50 % : un ingénieur SRE ne doit pas consacrer plus de la moitié de son temps aux tâches d’exploitation, l’autre moitié étant réservée au développement, à l’automatisation et à l’amélioration des systèmes.
Ce plafond n’est pas un confort, c’est un mécanisme de protection : sans lui, la charge d’exploitation absorbe tout le temps disponible et la fiabilité cesse de progresser.
Contrairement à un administrateur système ou un DevOps, l’ingénieur SRE combine compétences de développeur et d’exploitant pour construire des systèmes fiables et résilients. Ses responsabilités couvrent six domaines interdépendants :
Ce profil combine donc des compétences de développeur et d’exploitant. C’est ce qui distingue l’ingénieur SRE d’un administrateur système classique : il ne se contente pas de faire tourner la production, il écrit le logiciel qui la fait tourner mieux.
Une conséquence pratique du modèle SRE concerne les alertes. Plutôt que de multiplier les seuils techniques (charge processeur, espace disque), qui déclenchent des réveils inutiles sans effet sur l’utilisateur, on alerte sur la consommation anormale de l’error budget.
C’est le principe des alertes sur le rythme de consommation, ou burn rate : on prévient lorsque le budget se consomme assez vite pour menacer le SLO, avec des fenêtres courtes et longues combinées pour éviter les faux positifs.
Ce changement d’approche réduit fortement la fatigue d’alerte. Une alerte devient un signal qu’un engagement de service est en danger, donc une raison légitime de mobiliser une astreinte.
Les outils suivent cette évolution, avec des standards comme OpenSLO et des générateurs de règles pour Prometheus qui évitent d’écrire à la main les requêtes de calcul de burn rate pour chaque service.
Lancer une démarche SRE ne se fait pas du jour au lendemain. Elle demande une progression méthodique : choisir le bon périmètre, mesurer ce qui compte vraiment, puis cadrer les ressources. Voici les sept étapes pour débuter sans paralyser la production :
L’erreur la plus fréquente au démarrage est de fixer des SLO trop ambitieux.
Viser 99,99 % pour un service qui délivre historiquement 99,5 % crée une crise d’error budget immédiate et décourage les équipes.
Mieux vaut partir du réel et progresser.
Au-delà de ces étapes, six erreurs reviennent régulièrement lors du démarrage d’une démarche SRE. Les connaître permet de les anticiper et de protéger votre initiative :
Le DevOps est une culture et un ensemble de pratiques rapprochant développement et exploitation, à l’échelle de l’organisation. Le SRE est une discipline d’ingénierie plus prescriptive, centrée sur la fiabilité d’un service, avec des outils de décision chiffrés (SLI, SLO, error budget). Le SRE est souvent présenté comme une implémentation concrète de la philosophie DevOps.
Le SLI est l’indicateur mesuré (par exemple la part de requêtes réussies), le SLO est l’objectif interne fixé pour cet indicateur (par exemple 99,9 % sur 30 jours), et le SLA est l’engagement contractuel pris envers le client, assorti de conséquences. Le SLO interne doit toujours être plus strict que le SLA externe.
C’est la part d’indisponibilité autorisée par le SLO, soit l’écart entre 100 % et la cible. Pour un SLO de 99,9 % sur un mois, cela représente environ 43 minutes. Tant que le budget n’est pas épuisé, les équipes livrent ; une fois consommé, la priorité bascule vers la fiabilité.
C’est le travail d’exploitation manuel, répétitif, automatisable et sans valeur durable, qui croît avec la taille du service. Le SRE le mesure et le plafonne, avec la règle des 50 % maximum du temps d’un ingénieur, pour préserver du temps d’ingénierie et d’automatisation.
Non. Les deux sont complémentaires et se combinent très bien : la culture et les pratiques DevOps donnent le cadre, le SRE apporte les indicateurs et les règles de décision sur la fiabilité. En pratique, on suit conjointement les métriques DORA et la performance des SLO.
Par un service pilote : identifier les parcours utilisateurs clés, définir des SLI mesurables, fixer des SLO réalistes fondés sur la performance observée, formaliser la politique d’error budget, puis mesurer et réduire le toil.
Articles similaires
Semaphore : l'interface web open source qui pilote vos playbooks Ansible sans ligne de commande, de l'installation Docker à l'automatisation...
Le platform engineering offre aux développeurs une plateforme en libre-service et des golden paths pour livrer plus vite, sans dépendre...
CALMS : 5 piliers pour évaluer et piloter la maturité DevOps d'une organisation.