DCIM : piloter l’infrastructure de son data center
Le DCIM : visibilité en temps réel sur les trois enjeux qui comptent – capacité, énergie, risques.

Un rôle Ansible est une unité d’automatisation autonome et réutilisable qui regroupe, dans une arborescence normalisée, des tâches, des variables, des handlers, des templates et des fichiers. Il remplace les playbooks monolithiques par des briques composables, plus faciles à tester, à partager et à maintenir. C’est la structure de référence dès que l’automatisation dépasse quelques serveurs.
Ce guide détaille l’anatomie d’un rôle, la création avec ansible-galaxy, la gestion des variables (defaults et vars), l’appel dans un playbook, les dépendances, l’articulation avec les collections, les tests et les bonnes pratiques.
Un rôle est un ensemble cohérent de tâches et de ressources associées, rangé selon une convention de répertoires que Ansible connaît.
Quand vous appelez un rôle, Ansible charge automatiquement les fichiers attendus à leur emplacement standard, sans que vous ayez à indiquer chaque chemin. C’est cette convention qui rend les rôles portables d’un projet à l’autre.
Le besoin apparaît vite. Sur quelques machines, un playbook linéaire suffit. Dès que l’on gère des dizaines ou des centaines de serveurs, avec plusieurs environnements et plusieurs équipes, le playbook unique devient illisible, impossible à tester et impossible à réutiliser.
Le rôle répond à ce problème en encapsulant une responsabilité (installer et configurer un serveur web, durcir un système, déployer une application) derrière une interface claire faite de variables.
| Répertoire | Contenu | Fichier principal |
|---|---|---|
| tasks/ | Les tâches exécutées par le rôle | main.yml |
| handlers/ | Les handlers déclenchés par notify (redémarrage de service, rechargement) | main.yml |
| defaults/ | Variables par défaut, à la priorité la plus faible et donc facilement surchargeables | main.yml |
| vars/ | Variables internes du rôle, à priorité élevée et difficiles à surcharger | main.yml |
| templates/ | Modèles Jinja2 déployés par le module template | (fichiers .j2) |
| files/ | Fichiers statiques copiés tels quels | (fichiers) |
| meta/ | Métadonnées du rôle, dépendances et informations Galaxy | main.yml |
| tests/ | Playbook et inventaire de test du rôle | test.yml |
Tous ces répertoires ne sont pas obligatoires : Ansible ignore simplement ceux qui sont absents.
Un rôle minimal peut se réduire à un répertoire tasks contenant un fichier main.yml. La convention reste toutefois précieuse, car elle rend n’importe quel rôle immédiatement compréhensible par un tiers, ce qui compte autant que la qualité du code.
La commande ansible-galaxy génère l’arborescence complète d’un rôle, avec les fichiers main.yml attendus. C’est le point de départ recommandé, car il garantit le respect de la structure standard.
# Créer un rôle avec la structure standard

ansible-galaxy role init mon_role --init-path roles


# Arborescence générée

roles/mon_role/

├── defaults/main.yml

├── files/

├── handlers/main.yml

├── meta/main.yml

├── tasks/main.yml

├── templates/

├── tests/

└── vars/main.yml
Le fichier tasks/main.yml constitue le point d’entrée. Il contient les tâches du rôle, que l’on peut découper en plusieurs fichiers inclus lorsque le rôle devient volumineux, par exemple un fichier pour l’installation, un autre pour la configuration.
# roles/mon_role/tasks/main.yml

---

- name: Installer le paquet

  ansible.builtin.package:

    name: "{{ mon_role_package }}"

    state: present


- name: Déployer la configuration

  ansible.builtin.template:

    src: config.j2

    dest: "{{ mon_role_config_path }}"

notify: Redémarrer le service 
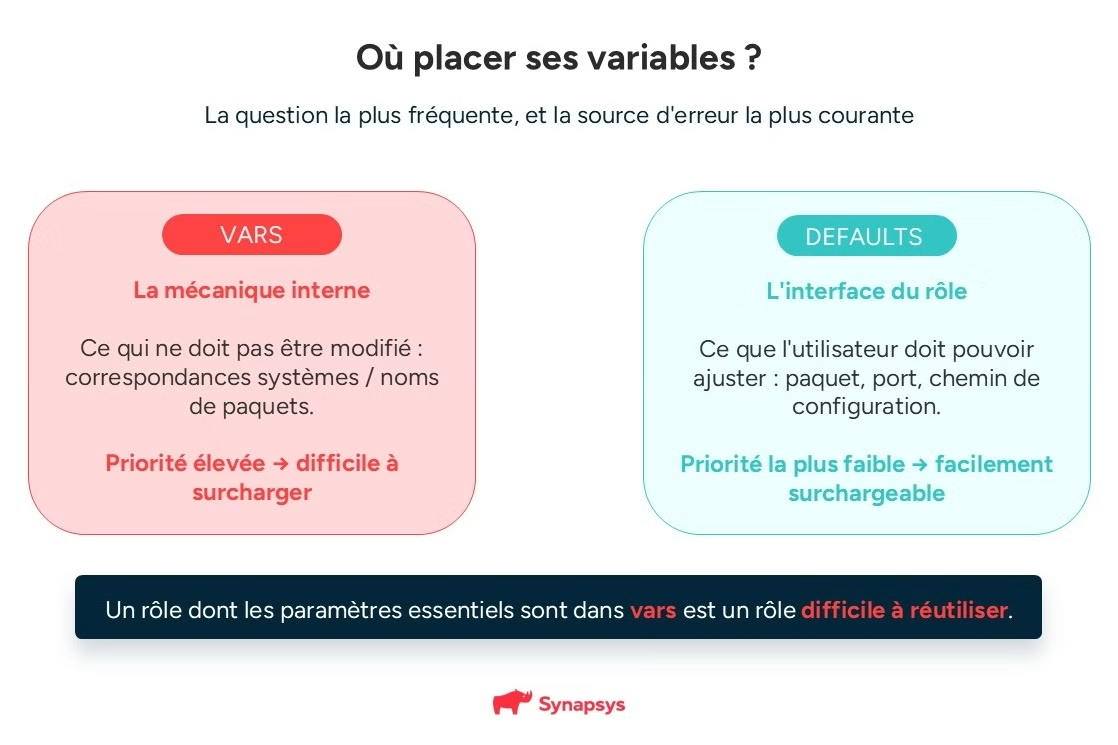
C’est la question la plus fréquente et la source d’erreur la plus courante. Les deux répertoires accueillent des variables, mais leur priorité diffère radicalement dans l’ordre de précédence d’Ansible :
La règle pratique est simple. Tout ce qui constitue l’interface du rôle, c’est-à-dire ce que l’utilisateur doit pouvoir ajuster, va dans defaults.
Tout ce qui relève de la mécanique interne et ne doit pas être modifié, comme une correspondance entre familles de systèmes et noms de paquets, va dans vars. Un rôle dont les paramètres essentiels sont placés dans vars est un rôle difficile à réutiliser.
# roles/mon_role/defaults/main.yml (surchargeable)

---

mon_role_package: nginx

mon_role_config_path: /etc/nginx/nginx.conf

mon_role_port: 80
Une convention largement adoptée consiste à préfixer toutes les variables par le nom du rôle.
Cela évite les collisions entre rôles, qui partagent le même espace de noms de variables, et rend immédiatement lisible l’origine de chaque paramètre.
Ces trois syntaxes coexistent, et leur différence a des conséquences pratiques :
# Appel classique par la section roles

---

- hosts: webservers

  roles:

    - role: mon_role

      mon_role_port: 8080


# Appel dynamique, conditionnable

- hosts: webservers

  tasks:

    - name: Appliquer le rôle si nécessaire

      ansible.builtin.include_role:

        name: mon_role

      when: deploy_web | bool
Le choix entre import et include dépend du besoin.
L’import statique est résolu au moment de l’analyse du playbook, ce qui permet notamment aux tags de s’appliquer à toutes les tâches du rôle.
L’inclusion dynamique est résolue à l’exécution, ce qui autorise les conditions et les boucles, au prix d’un comportement moins prévisible avec les tags.
Un rôle peut dépendre d’un autre, par exemple un rôle de configuration applicative qui suppose qu’un serveur web est déjà installé. Ces dépendances se déclarent dans meta/main.yml et sont exécutées avant le rôle appelant.
# roles/mon_role/meta/main.yml

---

dependencies:

  - role: base_web

    vars:

      base_web_port: 80
Pour les rôles et collections externes, la pratique consiste à les déclarer dans un fichier requirements.yml, puis à les installer avec ansible-galaxy. Cela rend les dépendances explicites, versionnées et reproductibles, ce qui est indispensable dans une chaîne d’intégration continue.
# requirements.yml

---

collections:

  - name: community.general

    version: ">=8.0.0"

roles:

  - src: https://github.com/exemple/role-nginx.git

    scm: git

    version: v1.2.0


# Installation

ansible-galaxy install -r requirements.yml Le mode de distribution a évolué. Depuis ansible-core 2.10, les collections sont le format de distribution du contenu Ansible : elles empaquettent des rôles, mais aussi des modules, des plugins et des playbooks. Galaxy NG, la plateforme Galaxy actuelle, ne prend plus en charge les anciens rôles standalone de Galaxy v1 : toute nouvelle distribution passe par une collection.
Cette évolution a une conséquence directe sur l’écriture des rôles : l’usage du nom de collection pleinement qualifié, ou FQCN. Écrire ansible.builtin.copy plutôt que copy est plus verbeux, mais évite qu’une collection installée ultérieurement ne redéfinisse silencieusement un module et ne modifie le comportement de vos rôles. C’est aujourd’hui la pratique recommandée pour tout nouveau contenu.
Pour l’hébergement, trois options coexistent :
Un rôle réutilisable doit être testé, sans quoi sa réutilisation propage les erreurs plutôt que la valeur. Molecule est l’outil de référence pour cela : il crée un environnement éphémère, généralement un conteneur, applique le rôle, puis vérifie le résultat. Il permet aussi de tester le rôle sur plusieurs distributions.
# Initialiser un scénario de test

molecule init scenario -r mon_role


# Cycle complet : création, application, vérification, destruction

molecule test
Deux vérifications complètent utilement les tests fonctionnels.
La première est l’idempotence : appliquer deux fois le rôle ne doit produire aucun changement au second passage, ce que Molecule contrôle nativement.
La seconde est l’analyse statique avec ansible-lint, qui repère les mauvaises pratiques et les erreurs de syntaxe avant l’exécution.
Les rôles Ansible bien structurés dès le départ restent maintenables et réutilisables. Suivre ces principes évite les dettes techniques qui s’accumulent à chaque réutilisation.
Certains raccourcis semblent inoffensifs au départ, mais propagent rapidement des défauts à travers tous vos projets. Reconnaître les pièges courants permet de les éviter dès la conception du rôle.
C’est une unité d’automatisation autonome et réutilisable qui regroupe tâches, variables, handlers, templates et fichiers dans une arborescence normalisée. Ansible charge automatiquement les fichiers à leur emplacement standard, ce qui rend les rôles portables d’un projet à l’autre.
Les variables de defaults ont la priorité la plus faible et sont conçues pour être surchargées : elles constituent l’interface du rôle. Celles de vars ont une priorité élevée et sont réservées à la mécanique interne. Placer un paramètre ajustable dans vars rend le rôle difficile à réutiliser.
Avec la commande ansible-galaxy role init, qui génère l’arborescence standard complète (tasks, handlers, defaults, vars, templates, files, meta, tests) et les fichiers main.yml attendus. Le point d’entrée est tasks/main.yml.
import_role importe le rôle de façon statique, résolue à l’analyse du playbook, ce qui permet aux tags de s’appliquer à toutes ses tâches. include_role l’inclut dynamiquement, à l’exécution, ce qui autorise conditions et boucles mais rend le comportement des tags moins prévisible.
Les deux se combinent. Le rôle reste l’unité d’organisation du contenu ; la collection est le format de distribution depuis ansible-core 2.10. Galaxy NG ne distribue plus les rôles standalone de Galaxy v1, donc toute nouvelle publication passe par une collection.
Avec Molecule, qui crée un environnement éphémère, applique le rôle et vérifie le résultat, y compris son idempotence. On y ajoute ansible-lint pour l’analyse statique, afin de repérer les mauvaises pratiques avant l’exécution.
Articles similaires
Le DCIM : visibilité en temps réel sur les trois enjeux qui comptent – capacité, énergie, risques.
Bleu, Microsoft 365 et Azure en environnement souverain : ce que garantit (et ne garantit pas encore) SecNumCloud à la...
L’infogérance Azure permet de déléguer la gestion, la sécurité et l’optimisation du cloud à un expert.