SRE et DevOps : différences, principes et mise en œuvre
Le SRE applique l'ingénierie logicielle à l'exploitation : une mise en œuvre concrète du DevOps, chiffrée par les SLI, SLO...
L’administration des infrastructures informatiques évolue constamment. Les serveurs physiques ont progressivement laissé place à la virtualisation, puis aux infrastructures cloud, aux conteneurs et à l’automatisation. Dans cette évolution, Linux reste un composant majeur des infrastructures modernes.
Serveurs web, bases de données, outils de supervision, plateformes de conteneurs, systèmes de stockage ou encore services cloud reposent très largement sur des distributions Linux telles que Red Hat Enterprise Linux, Rocky Linux, Ubuntu ou Debian.
En parallèle, une nouvelle technologie transforme progressivement les méthodes de travail des équipes informatiques : l’intelligence artificielle générative.
Les modèles de langage sont aujourd’hui capables d’analyser du texte, du code, des fichiers de configuration et des journaux système. Ils peuvent expliquer une erreur, proposer une commande ou encore formuler des hypothèses sur l’origine d’un incident.
Cela ouvre une possibilité particulièrement intéressante pour les ingénieurs systèmes : utiliser l’intelligence artificielle comme assistant lors du diagnostic d’un serveur Linux.
Mais une question se pose rapidement : une intelligence artificielle est-elle réellement capable de diagnostiquer un incident Linux de manière fiable ?
Pour répondre à cette question, il faut distinguer deux concepts :
Cette différence est fondamentale dans un environnement professionnel.
L’objectif de cet article est donc d’étudier les possibilités offertes par l’IA dans le troubleshooting Linux, puis de mettre en place un scénario expérimental permettant d’observer ses capacités et ses limites.
Lorsqu’un incident survient sur un serveur Linux, la première difficulté n’est généralement pas de connaître la commande permettant de résoudre le problème. Il faut avant tout identifier la cause réelle de l’incident.
Un serveur peut présenter des symptômes très différents :
L’ingénieur système dispose d’un grand nombre d’outils pour analyser la situation.
Quelques commandes classiques :
Ces commandes permettent d’obtenir des informations précises, mais chacune ne représente qu’une partie du problème.
Prenons un exemple simple : un service applicatif est arrêté.
Une première réaction pourrait être de simplement le redémarrer :
systemctl restart application.service
Mais cette action ne constitue pas un diagnostic.
Si le service s’arrête parce que le filesystem est saturé, le redémarrage ne fera que reproduire le problème.
L’ingénieur doit donc établir une chaîne logique : symptôme → hypothèses → vérifications → cause → remédiation → contrôle
Cette méthode nécessite de l’expérience et peut devenir particulièrement chronophage lorsqu’un incident implique plusieurs composants.
C’est précisément à cette étape que l’intelligence artificielle peut apporter une valeur supplémentaire.
Un modèle d’intelligence artificielle ne voit pas directement un serveur Linux.
Dans son utilisation classique, il travaille à partir des informations que l’ingénieur lui transmet.
On peut par exemple lui fournir :
L’IA peut ensuite analyser ces informations et proposer plusieurs hypothèses.
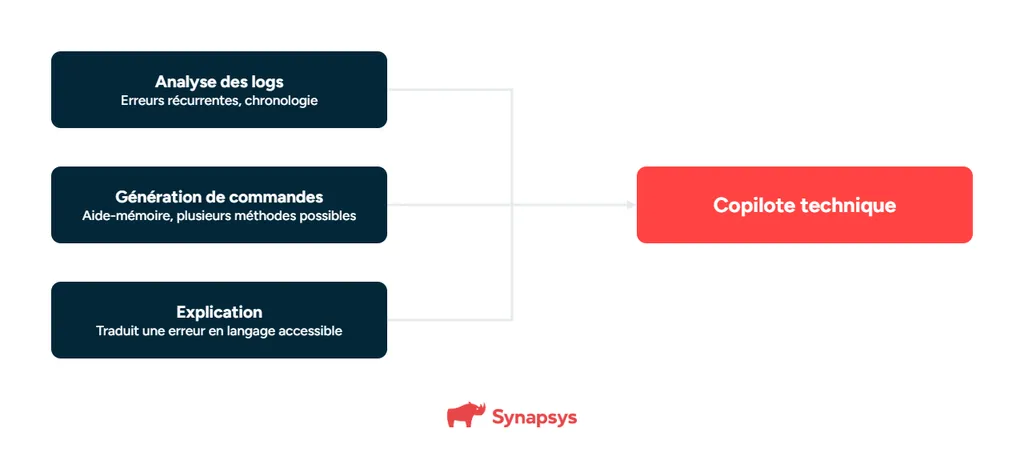
L’analyse des logs représente probablement l’un des cas d’utilisation les plus intéressants.
Un serveur peut générer plusieurs milliers de lignes de logs par jour. Lors d’un incident, l’ingénieur doit souvent identifier les événements pertinents parmi une grande quantité d’informations.
Une IA peut rechercher :
Elle peut également reconstruire une chronologie.
Par exemple :
10:32:15 application started
10:35:02 ERROR unable to write log
10:35:03 ERROR No space left on device
10:35:04 application stopped
L’IA peut rapidement identifier une relation entre la saturation du stockage et l’arrêt du service.
L’IA peut également servir d’aide-mémoire.
Un ingénieur sait généralement quelles informations il doit rechercher, mais il peut ne pas se souvenir immédiatement de la syntaxe exacte d’une commande.
Par exemple :
du -ah /var | sort -rh | head -20
permet d’identifier rapidement les éléments occupant le plus d’espace.
L’IA peut également générer des commandes plus complexes ou proposer plusieurs méthodes pour obtenir le même résultat.
Enfin, l’IA peut traduire un message technique en langage plus accessible.
Elle peut expliquer ce qu’implique une erreur, quelles pourraient être ses causes et quelles vérifications effectuer avant d’agir.
Elle devient ainsi une sorte de copilote technique.
Pour évaluer concrètement cette approche, un serveur Linux de test peut être volontairement dégradé.
L’objectif n’est pas de reproduire une panne extrêmement complexe, mais de construire un incident suffisamment réaliste pour nécessiter plusieurs étapes de diagnostic.
Le scénario choisi est celui d’un serveur Rocky Linux hébergeant une application interne.
Plusieurs symptômes sont introduits :
L’objectif est ensuite de donner les informations disponibles à une IA et d’observer si elle est capable de retrouver la cause principale.
La première action consiste à obtenir une vision générale du système.
uptime
free -h
df -h
systemctl –failed
Les résultats peuvent par exemple être :
| Filesystem | Size | Used | Avail | Use% | Mounted On |
|---|---|---|---|---|---|
| /dev/sda3 | 20G | 19G | 500M | 98% | /var |
Le filesystem /var est donc quasiment plein.
La mémoire est également fortement utilisée :
| total | used | free | |
|---|---|---|---|
| Mem | 7.7Gi | 7.4Gi | 150Mi |
Enfin, le service applicatif apparaît dans les services en échec.
À ce stade, l’ingénieur dispose de plusieurs pistes.
Il serait cependant prématuré de conclure que le manque d’espace disque constitue nécessairement la cause initiale.
Il faut continuer l’analyse.
L’étape suivante consiste à analyser l’état du service :
systemctl status application.service
Puis les événements récents :
journalctl -u application.service –since « 1 hour ago »
Les dernières lignes pourraient afficher :
ERROR unable to write application log
ERROR No space left on device
ERROR application shutting down
Une relation semble désormais apparaître.
Le service ne peut plus écrire dans ses fichiers et s’arrête.
Mais une nouvelle question apparaît :
Pourquoi le filesystem est-il plein ?
L’ingénieur doit maintenant identifier les répertoires responsables.
du -xh /var | sort -h | tail -20
Le résultat révèle par exemple que le répertoire /var/log/application occupe 15 Go.
L’enquête devient alors :
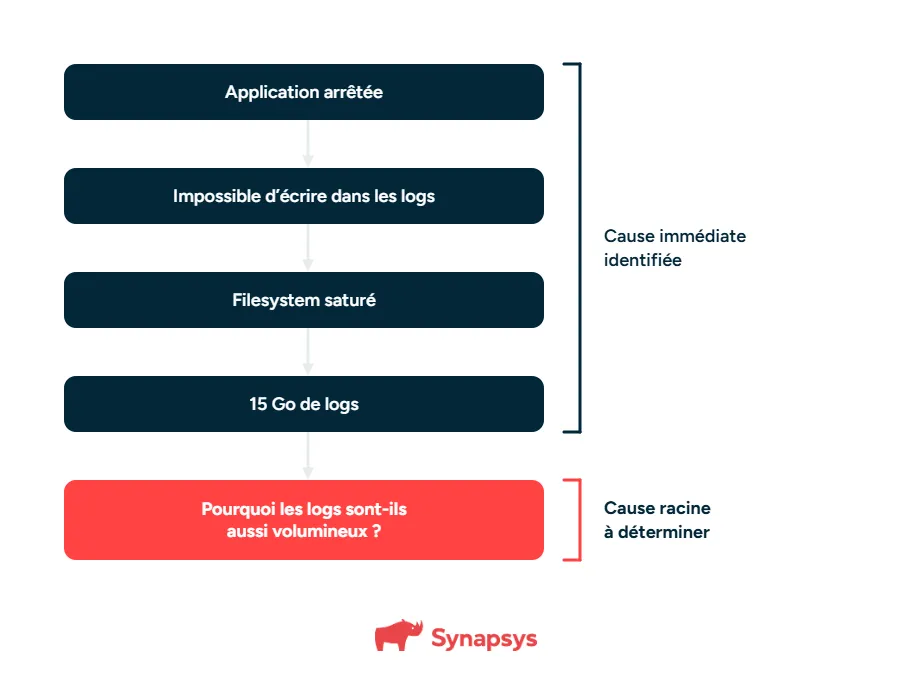
Les informations collectées sont maintenant transmises à l’IA.
La demande peut être formulée de manière volontairement simple :
« Voici l’état d’un serveur Rocky Linux dont une application est devenue indisponible. Analyse les informations fournies, identifie les causes probables et propose les vérifications à effectuer avant toute modification du système. »
Les informations transmises sont :
df -h
free -h
systemctl status application.service
journalctl -u application.service –since « 1 hour ago »
du -xh /var | sort -h | tail -20
L’IA peut alors établir une première chaîne de causalité :
Elle peut ensuite proposer des vérifications supplémentaires :
ls -l /etc/logrotate.d/
cat /etc/logrotate.conf
systemctl status logrotate.timer
journalctl -u logrotate
L’IA peut également demander à vérifier la configuration de l’application afin de rechercher une augmentation inhabituelle du niveau de logs.
Cette capacité à enchaîner plusieurs hypothèses et vérifications constitue l’un de ses principaux intérêts.
L’expérience permet de comparer deux approches.
| Étape | Ingénieur seul | Ingénieur + IA |
|---|---|---|
| Vérification système | Très rapide | Très rapide |
| Analyse des logs | Variable | Rapide |
| Recherche d’hypothèses | Expérience nécessaire | Plusieurs hypothèses proposées |
| Recherche de commandes | Documentation / mémoire | Génération immédiate |
| Corrélation des informations | Excellente avec expérience | Bonne, mais dépend du contexte |
| Compréhension de l’environnement | Excellente | Limitée |
| Décision finale | Humaine | Humaine |
| Risque d’action dangereuse | Contrôlable | Présent si l’IA est suivie aveuglément |
Cette comparaison montre que l’IA n’est pas forcément meilleure que l’ingénieur.
Elle est surtout complémentaire.
Un ingénieur expérimenté pourra parfois identifier le problème plus rapidement qu’un modèle généraliste.
En revanche, l’IA peut être particulièrement utile lorsqu’un problème sort des habitudes de l’administrateur ou lorsqu’il faut analyser rapidement une grande quantité d’informations.
L’une des principales limites des modèles d’intelligence artificielle est leur capacité à produire une réponse qui semble parfaitement cohérente alors qu’elle est incorrecte.
C’est particulièrement dangereux dans l’administration système.
Prenons un exemple.
Un serveur manque d’espace disque.
L’IA pourrait proposer :
rm -rf /var/log/*
Cette commande pourrait effectivement libérer de l’espace.
Mais elle pourrait également supprimer des logs nécessaires à une investigation, à la sécurité ou à des obligations de conservation.
Une solution plus raisonnable serait d’abord d’identifier les fichiers concernés, de vérifier leur utilité et d’utiliser les mécanismes prévus par le système, comme logrotate.
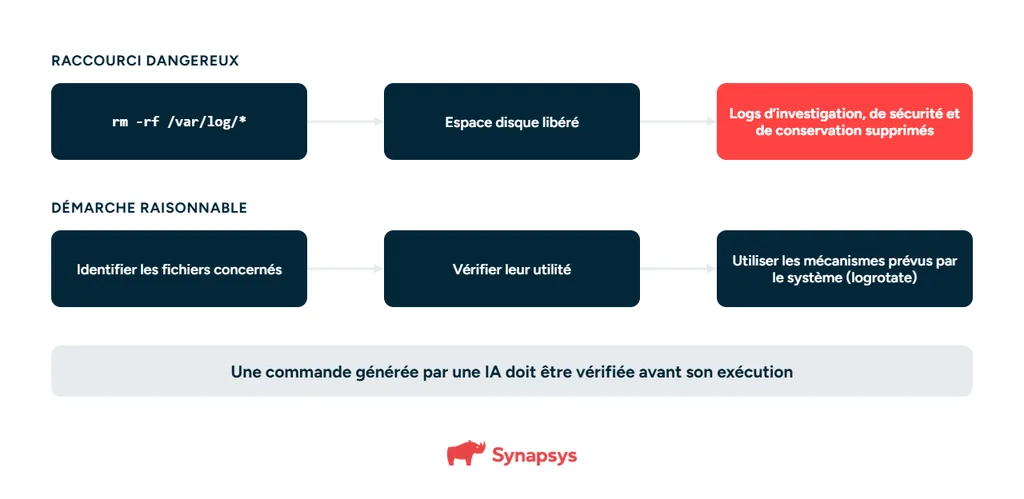
L’ingénieur doit donc conserver une règle essentielle : Une commande générée par une IA doit être vérifiée avant son exécution.
Cette règle devient encore plus importante lorsqu’une commande touche au stockage, au réseau, aux utilisateurs, aux permissions ou aux services critiques.
L’utilisation de l’IA dans une infrastructure professionnelle pose une seconde problématique : les données transmises au modèle.
Les logs peuvent contenir des informations sensibles :
Transmettre ces informations à un service externe sans contrôle peut donc constituer un risque.
Avant toute utilisation professionnelle, il est nécessaire de définir une politique claire.
Une solution consiste à anonymiser les données avant analyse :
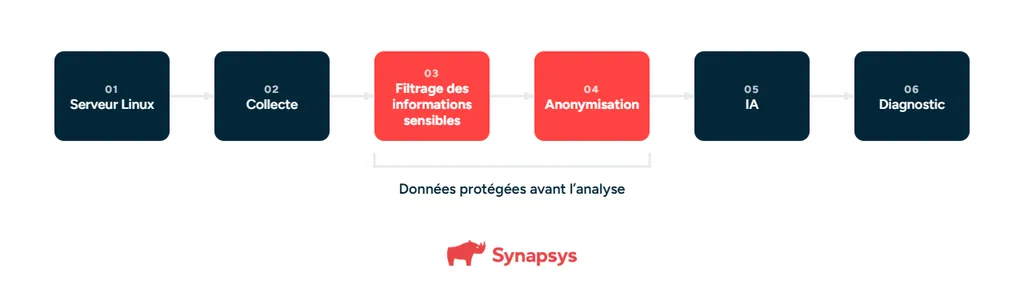
Une autre possibilité consiste à utiliser un modèle hébergé dans l’infrastructure de l’entreprise.
Cette approche peut être plus complexe à mettre en place, notamment en termes de puissance matérielle et d’administration, mais elle offre un contrôle plus important sur les données.
Le diagnostic assisté par IA représente seulement une première étape.
Un concept plus large commence également à se développer : l’AIOps, ou Artificial Intelligence for IT Operations.
L’objectif est d’utiliser l’intelligence artificielle directement dans les opérations informatiques.
Une infrastructure moderne peut déjà collecter un grand nombre de données :
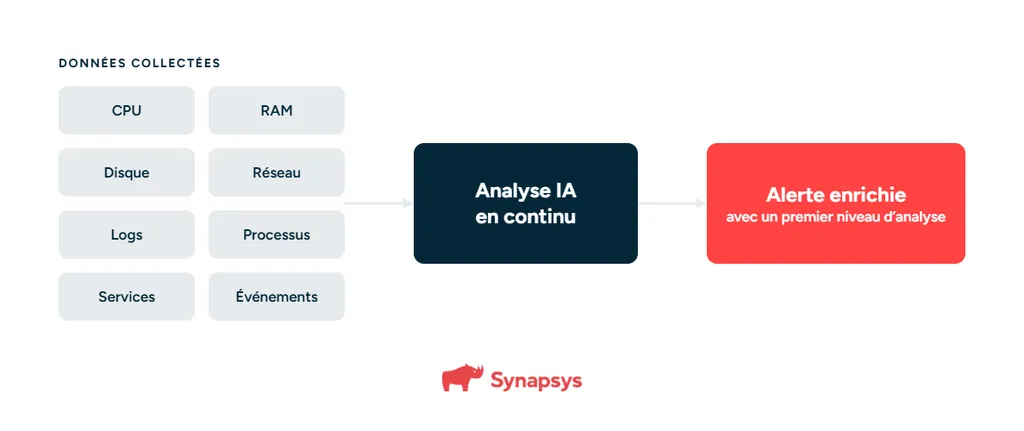
L’IA peut alors analyser ces informations en continu.
Prenons un serveur dont la consommation CPU habituelle est comprise entre 20 et 30 %.
Un système classique peut déclencher une alerte lorsque la consommation dépasse 80 %.
Une solution intégrant de l’IA pourrait aller plus loin et détecter qu’une augmentation progressive de la consommation est inhabituelle par rapport au comportement historique du serveur.
Elle pourrait alors produire une information telle que :
« La consommation CPU augmente progressivement depuis quatre heures. Le processus X représente actuellement 82 % de l’utilisation. Cette anomalie n’était pas présente lors des précédentes périodes d’activité. »
Le gain potentiel est important : l’ingénieur reçoit non seulement une alerte, mais également un premier niveau d’analyse.
L’étape suivante consiste à permettre à certains systèmes de corriger automatiquement les incidents.
On peut imaginer le fonctionnement suivant :
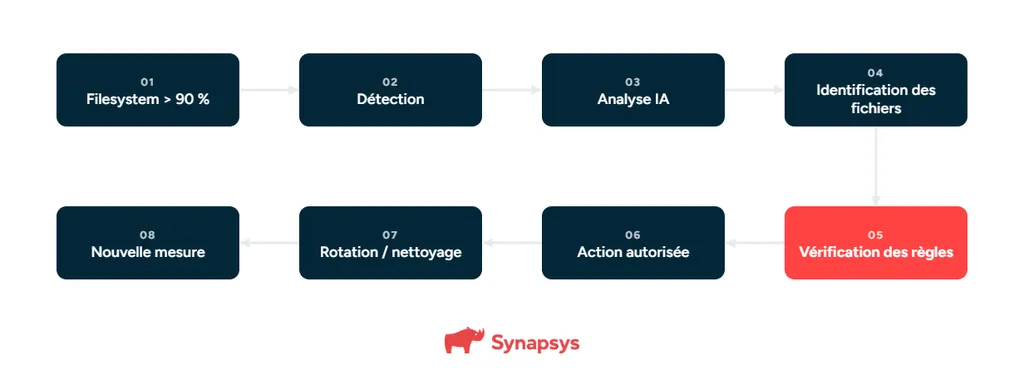
Dans un environnement maîtrisé, certaines opérations peuvent être automatisées.
Par exemple, une procédure pourrait être autorisée à lancer une rotation de logs lorsque plusieurs conditions précises sont réunies.
En revanche, une action telle que la suppression de fichiers système ou le redémarrage d’un serveur critique devrait nécessiter une validation humaine.
Il est donc possible d’imaginer plusieurs niveaux d’autonomie :
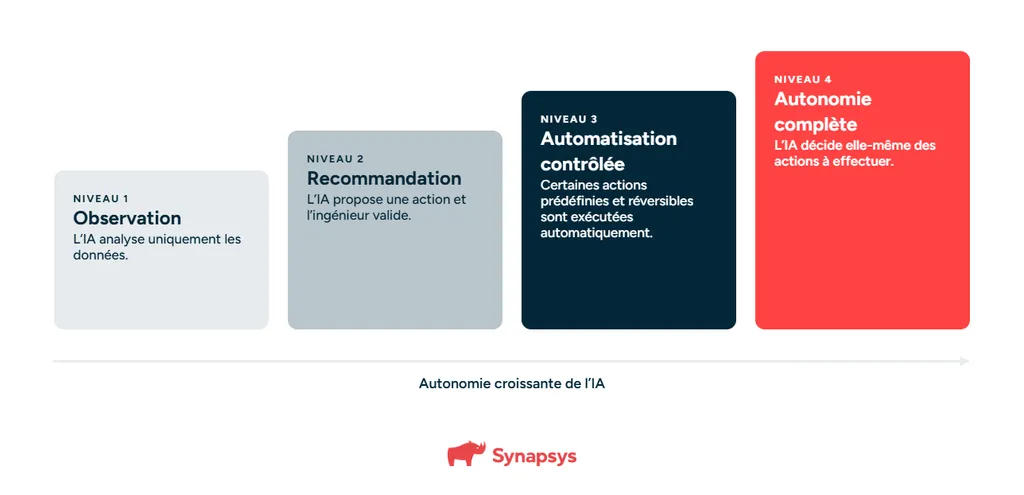
Le dernier niveau représente un risque important et doit être considéré avec beaucoup de prudence dans un environnement de production.
L’arrivée de l’IA peut donner l’impression que certaines tâches de l’ingénieur système vont progressivement disparaître.
Il est cependant plus probable que le métier évolue.
Les tâches répétitives sont les premières à pouvoir être automatisées :
En revanche, l’architecture et la prise de décision restent beaucoup plus complexes.
Un ingénieur système doit comprendre les dépendances entre les composants, les contraintes métier, les règles de sécurité et les conséquences potentielles d’une modification.
Une IA peut savoir qu’un serveur peut être redémarré avec :
reboot
Mais elle ne sait pas nécessairement que ce serveur héberge une application critique, qu’un changement est interdit pendant une période donnée ou qu’une autre équipe dépend actuellement de ce service.
La connaissance du contexte reste donc essentielle.
L’ingénieur de demain pourrait ainsi consacrer moins de temps à l’exécution et davantage de temps à :
L’IA ne supprimerait donc pas nécessairement le rôle de l’ingénieur système.
Elle pourrait au contraire devenir un nouvel outil de son métier, au même titre que la supervision, l’automatisation ou les systèmes de gestion de configuration.
L’intelligence artificielle apporte aujourd’hui de nouvelles possibilités dans l’administration des systèmes Linux.
Elle est capable d’analyser des logs, d’expliquer des erreurs, de générer des commandes, de proposer des hypothèses et de corréler plusieurs informations provenant d’un serveur.
L’expérimentation présentée dans cet article montre qu’une IA peut rapidement identifier une chaîne de causalité entre plusieurs symptômes : saturation du filesystem, accumulation de logs, impossibilité d’écrire sur le disque et arrêt d’un service.
Cependant, cette capacité ne signifie pas qu’un serveur Linux peut être confié sans contrôle à une intelligence artificielle.
Une IA peut manquer de contexte, proposer une mauvaise interprétation ou générer une commande dangereuse. Elle ne connaît pas nécessairement les contraintes propres à une entreprise et ne porte pas la responsabilité des conséquences d’une action.
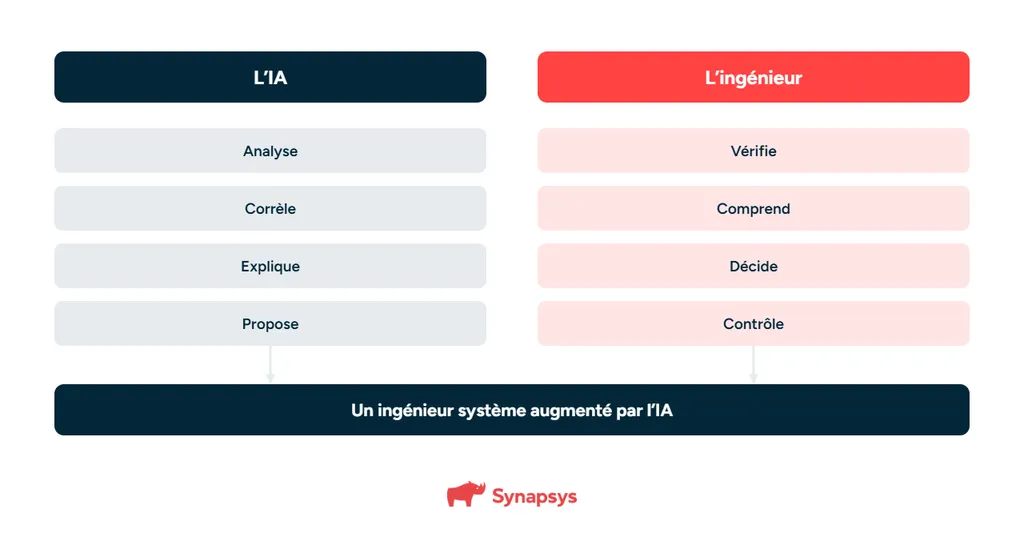
L’approche la plus réaliste est donc celle d’un ingénieur système augmenté par l’intelligence artificielle.
L’IA peut analyser, corréler, expliquer et proposer.
L’ingénieur vérifie, comprend, décide et contrôle.
À plus long terme, la combinaison de l’IA avec la supervision, l’automatisation et les outils d’orchestration pourrait permettre de créer des infrastructures capables de détecter et de corriger automatiquement certains incidents.
La question n’est donc probablement pas de savoir si l’IA remplacera l’ingénieur système Linux.
La véritable question est plutôt :
Comment l’ingénieur système peut-il utiliser l’intelligence artificielle pour réduire le temps consacré aux tâches répétitives et consacrer davantage de temps à la compréhension, à la sécurisation et à l’amélioration de son infrastructure ?
C’est probablement cette évolution qui constitue l’un des changements majeurs du métier d’ingénieur système au cours des prochaines années.
Articles similaires
Le SRE applique l'ingénierie logicielle à l'exploitation : une mise en œuvre concrète du DevOps, chiffrée par les SLI, SLO...
Semaphore : l'interface web open source qui pilote vos playbooks Ansible sans ligne de commande, de l'installation Docker à l'automatisation...
Le platform engineering offre aux développeurs une plateforme en libre-service et des golden paths pour livrer plus vite, sans dépendre...